Shadowing po japońsku wygląda na bardzo prosty: włączasz nagranie i zaczynasz mówić chwilę za lektorem. Początkująca osoba naciska odtwarzanie, goni każdą sylabę, po trzech sekundach traci zdanie i próbuje ponownie, tylko głośniej. Usta mogą poruszać się szybciej, ale osoba nadal nie potrafi wyjaśnić treści ani użyć zwrotu w rozmowie. Nie chodzi o brak wysiłku. Shadowing wymaga jednocześnie słuchania, przewidywania, pamięci, artykulacji i rozumienia, więc zbyt trudny fragment albo brak przygotowania zamienia ćwiczenie w naśladowanie szumu.
Lepsza rutyna chroni połączenie dźwięku z intencją. Wybierzesz bardzo krótki dialog, ustalisz, kto mówi i po co, podzielisz go na grupy frazowe, naprawisz trudne granice, podążysz za nagraniem z niewielkim opóźnieniem, a na końcu zmienisz komunikat. Materiały Irodori Japan Foundation definiują shadowing jako mówienie bezpośrednio za nagraniem, zanim cały dialog się skończy. Ten rytm jest ważny, lecz szybkość stanowi końcowe ograniczenie, a nie pierwszy cel. Poniższa metoda działa z każdym wyraźnym, legalnie dostępnym nagraniem dla uczących się i nie wymaga aplikacji.
Czym jest shadowing po japońsku, a czym nie jest
Przy powtarzaniu słuchasz całego zdania, robisz pauzę i odtwarzasz je z pamięci. W shadowingu zaczynasz mówić, kiedy model nadal kontynuuje wypowiedź, pozostając kawałek za nim jak cień. To nakładanie zmusza do uważnego śledzenia granic dźwięków, rytmu i kierunku frazy. Nie wymaga identycznego głosu ani aktorskiej imitacji. Pierwszym celem jest zrozumiała, stabilna wersja, która zachowuje grupy wypowiedzi i intencję bez utraty znaczenia.
Głośne czytanie razem z nagraniem to także inne ćwiczenie. Widoczny tekst prowadzi wzrok do przodu, a uszy mogą przestać przewidywać. Wskazówki dydaktyczne Marugoto opisują shadowing jako ćwiczenie przewidywania i zalecają ograniczenie pełnego zapisu, kiedy treść jest już jasna. Użyj tekstu chwilowo do sprawdzenia nieuchwytnej granicy, a potem go zakryj. Jeśli bez czytania nic nie działa, skróć fragment albo lepiej przygotuj język zamiast zamieniać ćwiczenie w zsynchronizowaną lekturę.
Wybierz jedną przystępną scenę, nie cały odcinek
Zacznij od dziesięciu–dwudziestu sekund i dwóch lub trzech wypowiedzi. Wybierz nagranie dla uczących się albo czystą codzienną rozmowę z wyraźnymi głosami i bez muzyki nakładającej się na słowa. Większość gramatyki i słownictwa powinna być już znana. Jedno nowe wyrażenie pomaga się rozwijać; linia wymagająca akapitu tłumaczenia nie jest gotowa do shadowingu. Przewidywalna sytuacja—zamówienie, powitanie współpracownika, potwierdzenie godziny czy pytanie o miejsce—nadaje każdemu dźwiękowi rolę.
Posłuchaj raz bez mówienia i odpowiedz: kto rozmawia, czego potrzebuje i co zmienia się na końcu? Gdy nie potrafisz odpowiedzieć, kolejnym krokiem jest rozumienie, a nie szybsze naśladowanie. Zmień fragment, jeśli nagranie jest niewyraźne, przesadnie aktorskie, pełne nazw własnych albo zdecydowanie za trudne. Krótsze, odpowiednie źródło daje więcej wartościowej uwagi niż ciągłe przetrwanie trudnej minuty. Wracaj do tego samego fragmentu tylko wtedy, gdy nadal poprawiasz konkretną cechę.
Zrozum rozmówców, zanim pożyczysz ich głosy
Zapisz jednozdaniową mapę sceny po polsku: „Klient pyta, czy zestaw lunchowy jest jeszcze dostępny; pracownik oferuje ostatni”. Następnie określ funkcję każdej japońskiej wypowiedzi—pytanie, potwierdzenie, poprawkę, propozycję, zgodę. Nie twórz pełnego tłumaczenia do czytania podczas ćwiczenia. Mapa ma przypominać, dlaczego głos się wznosi, łagodnieje albo zmienia kierunek. Znaczenie ułatwia słyszenie melodii, bo kontrast lub decyzja przestaje być niewyjaśnionym ruchem głosu.
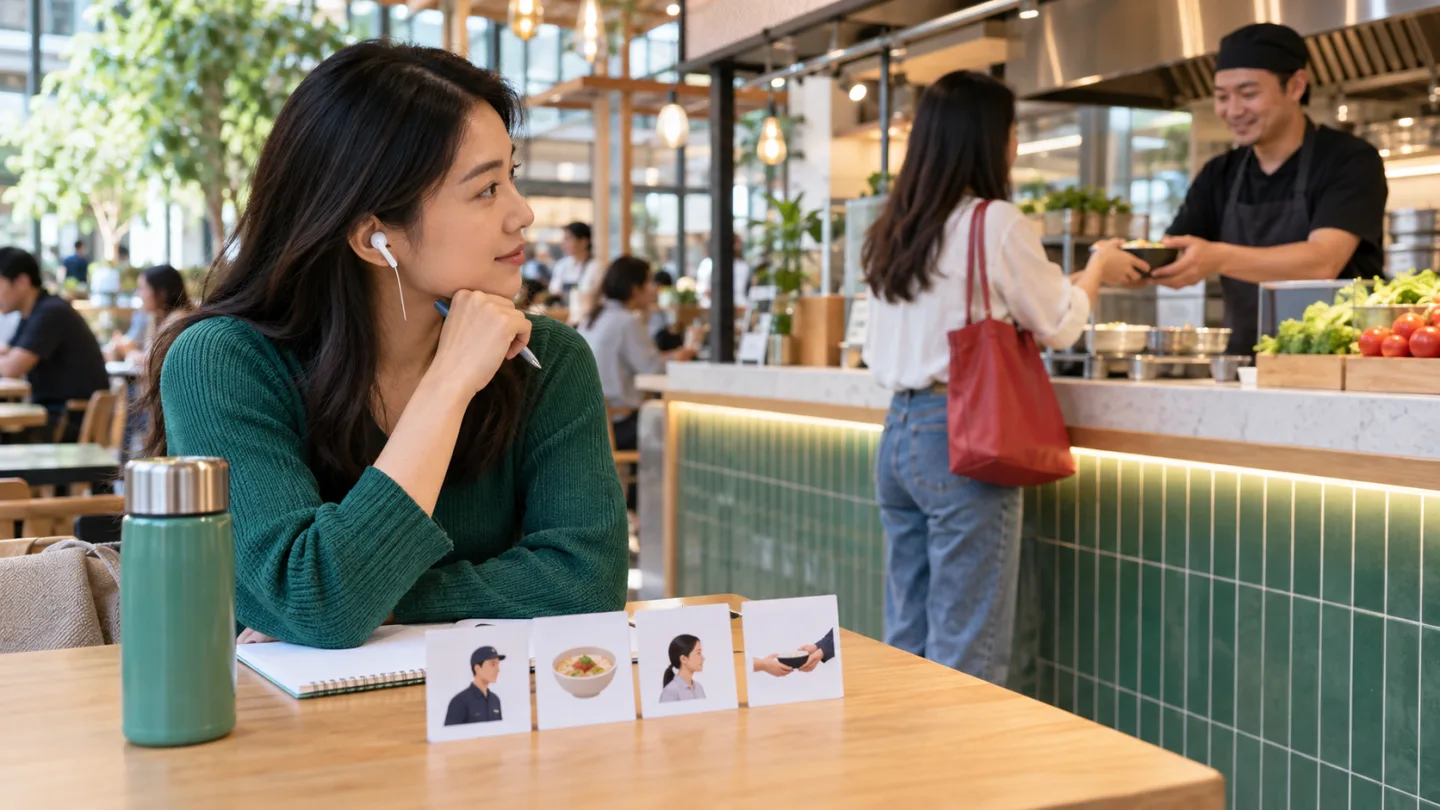
Sprawdź tylko słowa i gramatykę blokujące wymianę. W すみません、ランチセットはまだありますか rozpoznaj zwrot przyciągający uwagę, temat, まだ i pytanie o dostępność. W はい、あと一つあります zrozum, że została jedna sztuka. Gdy scena jest jasna, posłuchaj ponownie i wskaż każdą wypowiedź na prostej ilustracji albo karcie rozmówcy. Dźwięk ma uruchamiać sytuację, a nie polskie zdanie wstawione między nagranie a jego cel.
Zaznacz grupy frazowe i punkt decyzji
Odtwórz fragment i zaznacz tylko naturalne grupy, nie każde słowo: すみません / ランチセットは / まだありますか. Rytm japoński nie odpowiada polskiemu akcentowi, a ukośnik nie oznacza ciężkiej pauzy. Pokazuje, które dźwięki należą do siebie, zanim ucho samo rozpozna model. Otocz kółkiem miejsce niosące decyzję—まだ w pytaniu albo あと一つ w odpowiedzi. Ten punkt powinien pozostać słyszalny nawet wtedy, gdy pierwszy cień wypowiadasz bardzo cicho.
Stuknij raz na grupę frazową, a potem zanucaj albo wyszepcz kontur bez pełnych spółgłosek. Dzięki temu nie musisz od razu wymawiać każdego segmentu i możesz zauważyć, gdzie fraza płynie dalej, a gdzie opada. Wróć do słów na małej głośności. Nie wyolbrzymiaj wzoru wysokości, którego nie słyszysz pewnie, i nie wyprowadzaj melodii z rōmaji. Kopiuj grupowanie, rytm i nastawienie konkretnego nagrania. Szczegółowy akcent ćwicz osobno z wiarygodnym modelem.
Napraw jedną granicę dźwiękową przed pełnym cieniem
Znajdź miejsce, w którym wypowiedź się łamie: może まだありますか zlewa się w nieznany strumień albo przejście w あと一つ jest spóźnione. Zapętl najmniejszą użyteczną grupę. Posłuchaj, zatrzymaj, powtórz raz, a potem trzy razy mów razem z modelem. Takie chwilowe powtarzanie przygotowuje do shadowingu i nie jest porażką. Usta uczą się trudnego połączenia, zanim pamięć robocza będzie musiała jednocześnie śledzić kolejną frazę.
Nazwij przyczynę precyzyjnie. Jeśli nie słyszysz początku słowa, porównaj nagranie z tekstem, a potem zamknij zapis. Jeśli słyszysz, lecz nie umiesz powiedzieć, zwolnij własną próbę bez cyfrowego zniekształcania modelu. Jeśli umiesz powiedzieć, ale gubisz następną grupę, fragment jest za długi albo opóźnienie za duże. Gdy znika znaczenie, wróć do mapy sceny. Każda przyczyna wymaga innej naprawy; kolejne odtwarzanie całości traktuje wszystkie jak jeden problem.
Podążaj z małym opóźnieniem i cichym głosem
Zacznij tuż po pierwszych słowach i nie zatrzymuj się. Mów na tyle cicho, aby nadal wyraźnie słyszeć model; własny głos nie powinien zagłuszać słuchawek ustawionych na bezpieczną głośność. Pozwól jednej niejasnej sylabie minąć zamiast przerywać całą wymianę. Zachowaj grupę frazową i dołącz ponownie przy następnym znanym punkcie. Shadowing ćwiczy ciągłe śledzenie, dlatego przewijanie po każdej niedoskonałości usuwa właśnie to wymaganie.
Wykonaj trzy celowe przejścia. W pierwszym chroń rytm i nie oceniaj wymowy. W drugim wyraźnie zachowaj słowa decyzji oraz zmianę rozmówcy. W trzecim utrzymaj znaczenie i pełniej artykułuj dźwięki. Zakończ, zanim zmęczenie zamieni wszystko w rozmyty strumień. Nagrywaj czasem tylko ostatnie przejście; codzienne rejestrowanie może sprawić, że początkująca osoba zacznie kontrolować własny głos tak mocno, iż przestanie słuchać źródła.
Porównuj funkcję zamiast pytać, czy brzmisz jak native speaker
Posłuchaj własnego nagrania raz bez modelu. Czy odbiorca rozpozna dwie wypowiedzi, pytanie i końcową odpowiedź? Potem porównuj tylko jedną cechę: brakujące sylaby, grupowanie fraz, długie samogłoski, rytm poprawki albo zakończenie pokazujące nastawienie mówiącego. „Mam akcent” jest zbyt ogólne, by kierować naprawą. „Połknąłem długą samogłoskę w そうです” albo „zrobiłem pauzę wewnątrz ランチセット” daje konkretny kolejny krok.
Prowadź notatkę w trzech kolumnach: usłyszane, wypowiedziane, następna zmiana. Używaj kana albo krótkiego opisu dźwięku zamiast rozbudowanej teorii fonetycznej. Jeśli model nadal jest niemożliwy po dwóch skupionych naprawach, wybierz łatwiejszy fragment. Shadowing nie jest testem wytrzymałości, a identyczność z jednym głosem nie stanowi normy. Postęp oznacza, że śledzisz większą część zrozumiałej wiadomości, zachowujesz ważne kontrasty i wracasz po małym potknięciu.
Wyjdź z cienia i zmień komunikat
Skopiowany dialog staje się użytecznym językiem dopiero wtedy, gdy można go zmienić. Zachowaj sytuację, lecz podmień jeden fakt: ランチセット na カレー, あと一つ na あと二つ albo odpowiedź na すみません、もうありません. Powiedz zmienioną wymianę bez nagrania. Następnie zamknij model i odpowiedz na powiązane pytanie o własną sytuację. Ten krok pokazuje, czy dźwięk pozostał połączony ze znaczeniem, czy sekwencja przetrwała jedynie jako pamięć mięśniowa.
Ćwicz z partnerem, jeśli możesz, ale nagranie obu ról również działa. Reaguj naturalnie i nie próbuj zachować każdego elementu rytmu modelu, gdy zmieniła się treść. Komunikacja może wymagać nowej pauzy lub nacisku. Wzór daje stabilny punkt startowy, a nie klatkę. Tok nauczania Irodori także umieszcza shadowing przed ćwiczeniem kontrolowanym, a potem przed swobodniejszą wypowiedzią, dzięki czemu płynne naśladowanie prowadzi do rzeczywistego celu komunikacyjnego.
Zastosuj siedmiodniowy cykl shadowingu po japońsku
Pierwszego dnia wybierz i zrozum fragment. Drugiego zaznacz grupy oraz napraw jedną granicę. Trzeciego i czwartego wykonaj trzy krótkie przejścia i zanotuj jedną zmianę. Piątego zrób cień bez tekstu oraz dwie podmiany. Szóstego opowiedz sytuację albo odegraj ją z nową treścią. Siódmego wróć raz do oryginału, nagraj się i zdecyduj, czy zakończyć pracę. Dziesięć uważnych minut wystarczy; dłużej pracuj tylko wtedy, gdy uwaga pozostaje dokładna.
Mierz postęp zadaniami, nie niejasną płynnością. Czy potrafisz wyjaśnić scenę, podążać bez zapisu, zachować kluczowy kontrast, wrócić po zgubieniu sylaby i stworzyć nową odpowiedź? Jeśli tak, wybierz fragment z jednym umiarkowanym wyzwaniem: innym głosem, trochę dłuższą wypowiedzią albo jednym nowym wzorem. Jeśli nie, wskaż nieudany etap i powtórz go zamiast zaczynać tydzień od zera. Shadowing po japońsku działa najlepiej, gdy każde nagranie przechodzi od zrozumianego materiału przez kontrolowane podążanie do samodzielnej mowy.
Po zakończeniu cyklu zachowaj tylko krótką notatkę o tym, co rzeczywiście się poprawiło. Nie gromadź dziesiątek nagrań, do których nigdy nie wrócisz. Jedno zdanie typu „utrzymałem pytanie, ale zgubiłem długą samogłoskę w odpowiedzi” wystarczy, aby wybrać następny materiał. Nowy dialog powinien zachować większość znanych wymagań i dodać jedną zmianę. Dzięki temu kolejne tygodnie budują sprawność warstwami, zamiast stale sprawdzać, ile trudności potrafisz znieść naraz.