Shadowing em japonês parece simples: você dá play e fala logo atrás da gravação. Quem está começando tenta perseguir cada sílaba, perde a frase depois de três segundos e repete tudo mais alto. A boca pode ficar mais rápida, mas a pessoa ainda não sabe explicar o que ouviu nem usar a expressão em uma conversa. O problema não é falta de esforço. O shadowing exige escuta, previsão, memória, articulação e significado ao mesmo tempo; um trecho inadequado ou uma preparação ausente transforma a atividade em imitação de ruído.
Uma rotina melhor protege a ligação entre som e intenção. Você vai escolher um diálogo curtíssimo, entender quem fala e por quê, mapear os blocos da frase, reparar limites difíceis, acompanhar o áudio com um pequeno atraso e depois mudar a mensagem. O material Irodori da Japan Foundation define shadowing como falar imediatamente atrás do áudio, sem esperar o diálogo inteiro terminar. Esse tempo importa, mas a velocidade é a restrição final, não o primeiro objetivo. A sequência abaixo oferece um método completo para iniciantes, funciona com qualquer gravação didática clara e legalmente disponível e não depende de aplicativo.
O que é shadowing em japonês — e o que não é
Na repetição, você ouve a frase inteira, faz uma pausa e a reproduz de memória. No shadowing, começa a falar enquanto o modelo continua, mantendo uma pequena distância, como uma sombra. Essa sobreposição obriga a prestar atenção aos limites sonoros, ao ritmo e à direção da frase. Não é preciso ter voz idêntica nem fazer uma imitação teatral. O primeiro alvo é uma versão compreensível e estável que preserve os grupos da fala e a intenção sem abandonar o significado.
Ler em voz alta junto com o áudio também é diferente. O texto visível pode puxar os olhos para a frente enquanto os ouvidos deixam de prever. A orientação didática do Marugoto explica que shadowing envolve previsão e recomenda evitar o texto completo depois que a compreensão estiver firme. Use a transcrição temporariamente para conferir um limite perdido e volte a cobri-la. Se nada funciona sem leitura, encurte o trecho ou prepare melhor a linguagem, em vez de transformar a atividade em leitura sincronizada.
Escolha uma cena administrável, não um episódio inteiro
Comece com dez a vinte segundos e duas ou três falas. Escolha áudio criado para estudantes ou uma troca cotidiana limpa, com vozes distintas e sem música por cima. Você já deve conhecer a maior parte da gramática e do vocabulário. Uma expressão nova traz avanço; uma fala que exige um parágrafo de tradução ainda não está pronta. Situações previsíveis—fazer um pedido, cumprimentar um colega, confirmar um horário ou perguntar onde algo fica—dão uma função comunicativa a cada som.
Ouça uma vez sem falar e responda: quem conversa, o que precisa e o que muda até o final? Se não souber, o próximo passo é compreensão, não imitação mais veloz. Troque o trecho quando a gravação estiver abafada, excessivamente dramática, cheia de nomes ou muito acima do seu nível. Uma fonte curta e adequada oferece atenção mais útil que sobreviver várias vezes a um minuto difícil. Mantenha o mesmo áudio por alguns dias somente enquanto uma característica específica ainda estiver melhorando.
Entenda os falantes antes de pegar emprestada a voz deles
Escreva um mapa da cena em uma linha: “Cliente verifica se ainda há o prato do almoço; atendente oferece o último”. Depois indique a função de cada fala japonesa—pergunta, confirmação, correção, oferta, aceitação. Não faça uma tradução completa para ler durante o exercício. O mapa serve para lembrar por que a voz sobe, suaviza ou muda de direção. O significado torna a prosódia mais perceptível, pois um contraste ou uma decisão final deixa de ser apenas um movimento de voz inexplicado.
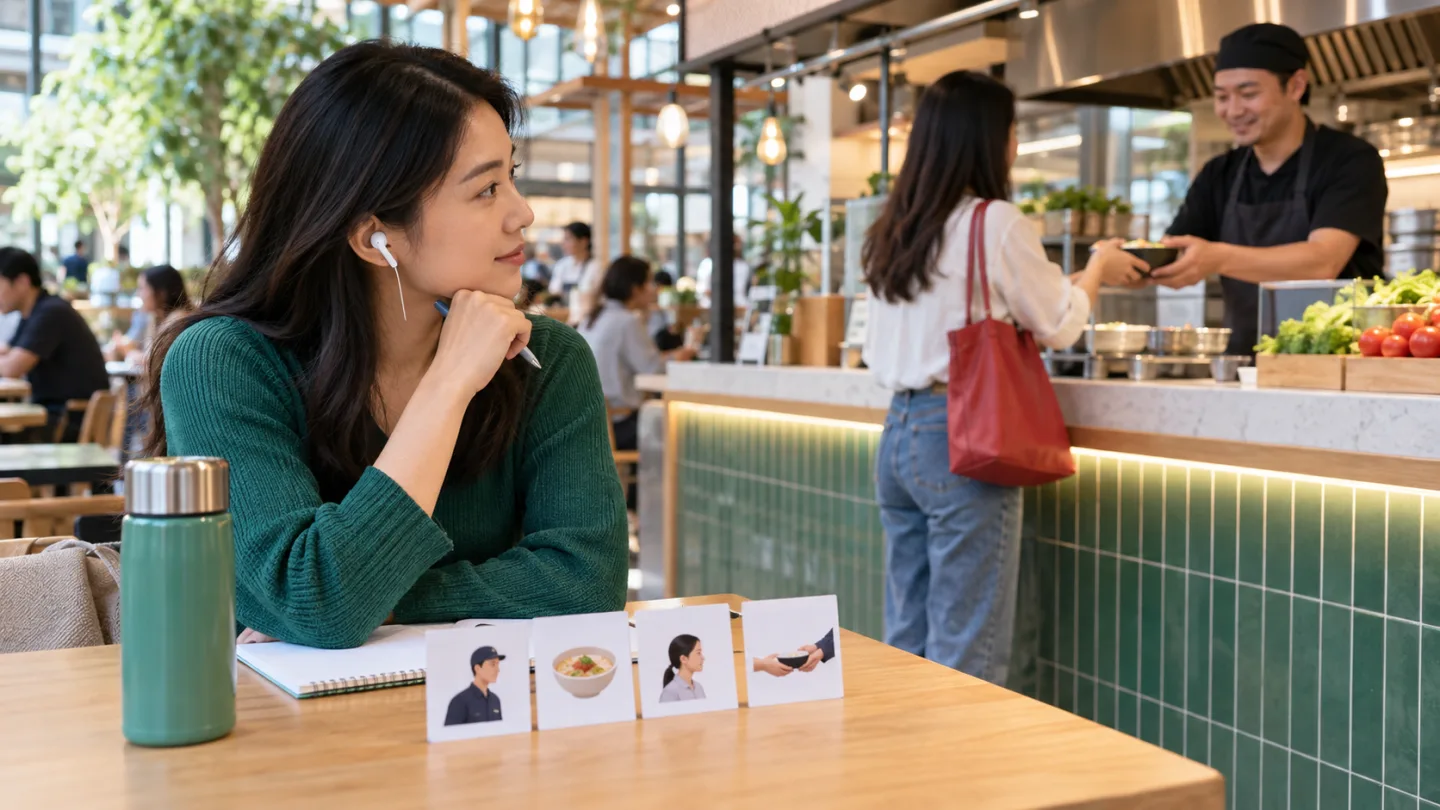
Confira apenas as palavras e a gramática que bloqueiam a troca. Em すみません、ランチセットはまだありますか, identifique a chamada, o tópico, まだ e a pergunta sobre disponibilidade. Em はい、あと一つあります, entenda que resta uma unidade. Quando a cena estiver clara, ouça novamente e aponte cada fala em um desenho simples ou cartão de personagem. Você treina o áudio para ativar uma situação, não uma frase em português colocada entre o som e sua finalidade.
Marque os blocos da frase e o ponto de decisão
Toque o áudio e marque apenas grupos naturais, não todas as palavras: すみません / ランチセットは / まだありますか. O tempo do japonês não corresponde ao padrão de acento do português, e a barra escrita não manda fazer uma pausa pesada. Ela mostra quais sons ficam juntos enquanto o ouvido aprende o modelo. Circule o ponto que carrega a decisão—まだ na pergunta ou あと一つ na resposta. Esse ponto deve continuar audível mesmo quando sua primeira sombra sair em voz baixa.
Bata uma vez por bloco, depois cantarole ou sussurre o contorno sem formar todas as consoantes. Isso reduz a pressão de pronunciar cada segmento enquanto você nota onde a frase continua e onde conclui. Volte às palavras com volume baixo. Não exagere um padrão de altura que você não consegue ouvir com segurança e não invente uma melodia a partir de rōmaji. Copie o agrupamento, o tempo e a atitude da gravação específica. O estudo detalhado do acento pode vir separado, com modelo e explicação confiáveis.
Repare um limite sonoro antes do shadowing completo
Encontre o ponto em que sua fala quebra: talvez まだありますか se compacte em um fluxo desconhecido, ou a passagem de あと一つ chegue tarde. Repita somente o menor bloco útil. Ouça, pause, repita uma vez e fale com o modelo três vezes. Essa repetição temporária prepara o shadowing e não representa fracasso. Ela deixa a boca aprender uma fronteira difícil antes que a memória de trabalho também precise acompanhar o grupo seguinte.
Diagnostique a causa. Se você não ouve onde a palavra começa, compare áudio e transcrição e depois feche o texto. Se ouve mas não consegue dizer, desacelere seu próprio ensaio sem distorcer digitalmente o modelo. Se consegue falar mas perde o bloco seguinte, o trecho está longo demais ou seu atraso aumentou. Se o significado some, volte ao mapa da cena. Cada causa pede um reparo diferente; tocar tudo outra vez trata problemas distintos como se fossem um só.
Acompanhe com pequeno atraso e voz baixa
Comece logo depois das primeiras palavras e continue. Fale baixo o bastante para ainda ouvir o modelo; sua voz não deve cobrir os fones em volume seguro. Deixe uma sílaba incerta passar em vez de interromper toda a troca. Preserve o bloco e retorne no próximo ponto conhecido. Shadowing treina acompanhamento contínuo, portanto voltar depois de cada imperfeição elimina justamente a exigência que você quer praticar.
Faça três passagens com propósito. Na primeira, proteja o tempo sem julgar pronúncia. Na segunda, deixe claras as palavras de decisão e a mudança de falante. Na terceira, preserve o significado enquanto completa melhor a articulação. Pare antes que o cansaço transforme tudo em fluxo indistinto. Grave apenas a última passagem de vez em quando; gravar diariamente pode levar iniciantes a monitorar tanto a própria voz que deixam de escutar a fonte.
Compare a função em vez de perguntar se parece nativo
Ouça sua gravação uma vez sem o modelo. Alguém consegue identificar as duas falas, a pergunta e a resposta final? Compare então apenas um aspecto por vez: sílabas ausentes, blocos, vogais longas, o tempo de uma correção ou a terminação que mostra a postura do falante. “Tenho sotaque” é amplo demais para orientar um reparo. “Engoli a vogal longa em そうです” ou “pausei dentro de ランチセット” cria uma próxima tentativa específica.
Mantenha três colunas: ouvi, produzi, próxima mudança. Use kana ou uma descrição curta do som, não uma longa teoria fonética. Se o modelo continuar impossível depois de dois reparos focados, desça para um áudio mais fácil. Shadowing não é teste de resistência, e soar igual a uma pessoa não é o padrão. Melhorar significa acompanhar mais de uma mensagem compreensível, preservar os contrastes importantes e se recuperar depois de uma pequena perda.
Saia da sombra e mude a mensagem
Um diálogo copiado só vira linguagem útil quando pode ser alterado. Mantenha a interação e troque um fato: ランチセット por カレー, あと一つ por あと二つ, ou a resposta por すみません、もうありません. Diga a nova troca sem áudio. Depois feche o modelo e responda a uma pergunta ligada à sua realidade. Essa etapa testa se som e sentido permaneceram conectados ou se a sequência sobreviveu apenas como memória muscular.
Use uma dupla se possível, mas gravar os dois papéis também funciona. Responda naturalmente em vez de conservar cada ritmo do modelo quando o conteúdo muda. A comunicação pode pedir outra pausa ou ênfase. O modelo oferece um padrão inicial estável, não uma prisão. O fluxo didático do Irodori também coloca shadowing antes da prática controlada e depois da fala mais livre, mantendo a imitação fluente ligada a um objetivo comunicativo real.
Siga um ciclo de sete dias de shadowing em japonês
No primeiro dia, escolha e entenda o trecho. No segundo, marque os blocos e repare um limite. Nos dias três e quatro, faça três passagens curtas e registre uma mudança. No quinto, acompanhe uma vez sem texto e faça duas substituições. No sexto, reconte ou represente a situação com conteúdo novo. No sétimo, volte uma vez ao original, grave e decida se pode encerrar o trecho. Dez minutos atentos bastam; mais tempo só ajuda se a atenção continuar precisa.
Meça progresso com tarefas, não com uma sensação vaga de fluidez. Você consegue explicar a cena, acompanhar sem transcrição, preservar o contraste central, voltar depois de uma falha e criar outra resposta? Se sim, escolha um áudio com um desafio modesto: outra voz, turno um pouco maior ou uma estrutura desconhecida. Se não, identifique a etapa que falhou e repita essa etapa, sem reiniciar a semana. Shadowing em japonês se torna produtivo quando cada gravação passa de entrada compreendida a acompanhamento controlado e, por fim, fala independente.